九成是知识,一成是判断
专业 = 知识 + 判断
越简单的岗位越先被替代——这个直觉是错的,而且错得很有价值。
01这篇只拆一项
前面一篇文章我们讲了人力资源不断往下沉市场搬迁已经到头了的分析,这一篇我们具体就单个岗位的替代率来做一个深度的分析。
可以归纳为一个公式:
AI 替代价值 = 存量人数 × 单人成本 × 可替代比例
前两项是成本视角,上一篇已经算完了——四十年的地理差价,一路搬到县城只剩 9%,走到头了。
这一篇只拆第三项:可替代比例。
它和前两项不一样。存量人数、单人成本是市场给的,你只能选;而可替代比例是这个岗位自身的结构决定的,拆开就能算。
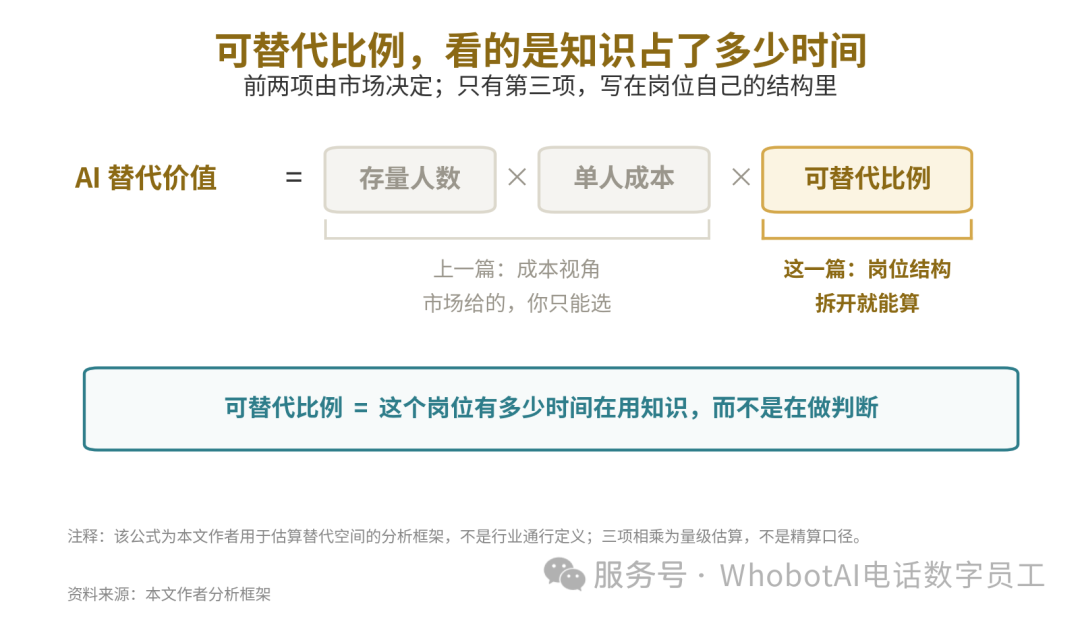
▲ 图1:前两项是市场给的,第三项写在岗位自己的结构里
问题是,大部分人算它的时候,用错了尺子。
02把「专业」这个词拆开
大多数人对 AI 替代的直觉是:越简单的岗位越先被替代。
这个直觉是错的。而且错得很有价值——因为它会让你把第三项算反。
真正的尺子是这个:
专 业 = 知 识 + 判 断
知识 · 能被完整编码的那一半
指南、条款、SOP、病历规范、产品参数、什么情况该怎么办、哪句话不能说。它有标准答案,只是这个答案很长、很碎、需要有人花时间去学。
判断 · 不能被完整编码的那一半
这个人语气变了要不要停下来、这个例外要不要破格、这条线索到底算不算数。它没有标准答案,只能由人来拿主意,也只能由人来担后果。
这两半的可编码程度,差了一个数量级。
知识可以被完整编码——AI 在这一侧已经赢了。所有的指南、条款、SOP、病历规范,它都读过,而且不会忘、不会漏、不会有记忆偏差。
判断不能被完整编码——这是人的护城河。
接下来是这篇文章最关键的一个事实:
关键事实
大多数专业岗位,日常工作的九成是在用知识,不是在做判断。 真正需要「拿主意」的时刻,一天可能就那么几次。
把这句话和上面那个公式合起来,第三项就有答案了——可替代比例 ≈ 这个岗位有多少时间在用知识。不是它难不难,也不是它专不专业。
03「九成」长什么样
这个数字听起来很虚,拿一个具体岗位拆一遍就实了。
一家白癜风专科连锁的初筛电话,链路是这样的:
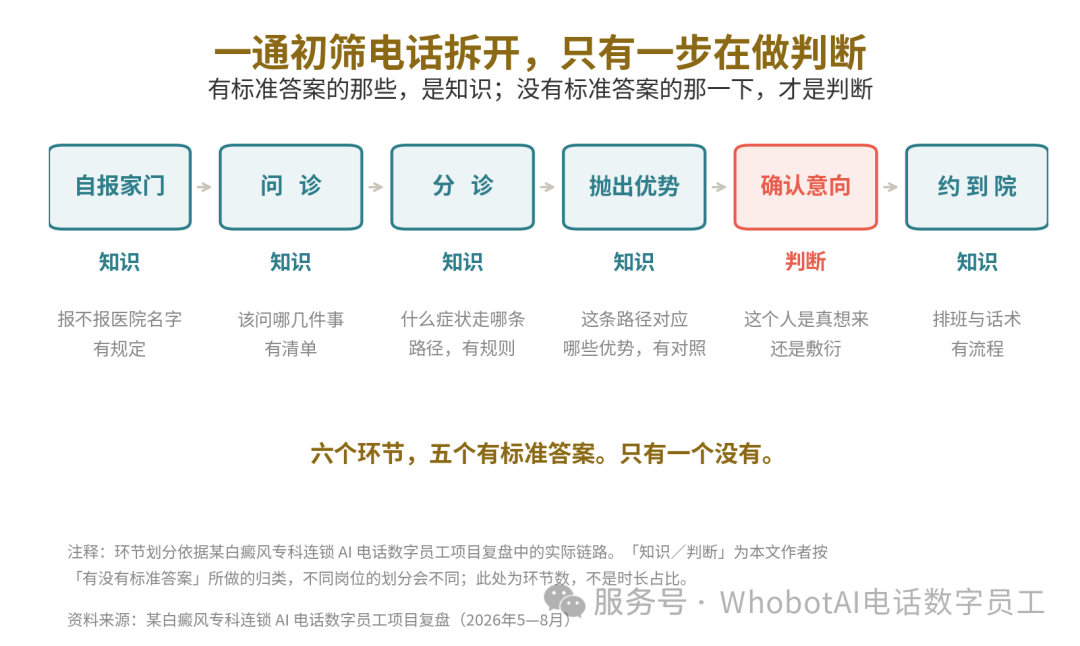
▲ 图2:一通医疗初筛电话的完整链路
逐个看:
- 自报家门报不报医院名字,这行有规定——知识
- 问诊病程多久、面积多大、长在什么部位、之前用过什么药,该问哪几件事有清单——知识
- 分诊什么症状走哪条治疗路径,有规则——知识
- 抛出优势这条路径对应医院的哪些优势,有对照——知识
- 确认意向这个人是真想来还是敷衍,没有标准答案——这一下才是判断
- 约到院排班和话术,有流程——知识
也就是说,这个岗位的可替代比例,天然就在九成上下。
而它恰恰是市场上最难招的一类。客户自己的描述是——
医学生不爱干,普通销售上手慢。
难招和可替代比例高,在这里是同一件事的两个说法:正因为要先学一套东西,供给才少;也正因为那套东西有标准答案,AI 才接得住。
反过来看那些「简单」的岗位。门店接待、保洁、搬运——它们的时间不花在知识上,花在在场和体力上。知识占比极低,可替代比例也就极低。
所以
直觉错在哪:它把「难度」当成了「知识占比」。 而这两件事之间,没有关系。
04知识这一侧,AI 已经赢了
为什么说「已经赢了」,而不是「会赢」?因为这一侧的胜负早就分出来了,只是分两层。
第一层:存量
一个从业者要花十年才读得完的东西——所有的指南、条款、SOP、病历规范、话术手册——它已经读完了。这一层没什么可争的。
但光有这一层还不构成替代。读过不等于用对,这一点第五节再说。
第二层:装载和复制
真正决定胜负的是这一层:同一套知识装进人和装进 AI,是两条完全不同的曲线。
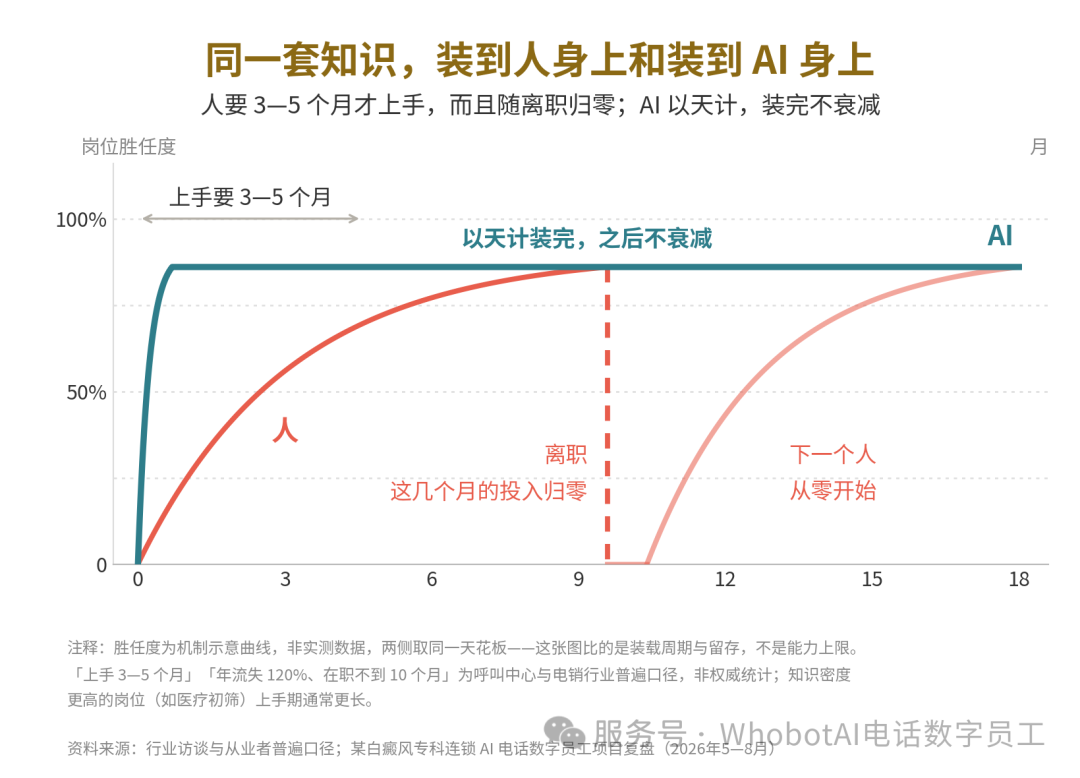
▲ 图3:一边要几个月还会归零,一边以天计且不衰减
人这一侧,三件事同时成立:装载周期以月计、装的过程中产出打折、装完了会走。而且往往是刚装完就走——一个人把这套东西全学明白之后,他知道自己现在值更多。
粗算一笔账:一个坐席从入职到胜任 3—5 个月,爬坡期产出打折,加上招聘和带教,单人重置成本大致 1.2 万—2 万元;按行业普遍口径年流失 120% 算,一个 50 人的团队一年要重装 60 个人——每年 70 万—120 万,只是把同一套知识重新装进新的人脑里。
换到 AI 这边,同样几件事的成本结构是这样的:
| 装到人身上 | 装到 AI 身上 | |
|---|---|---|
| 装载周期 | 3—5 个月上手 | 以天计 |
| 装第二份 | 从头再来一遍 | 复制,边际成本≈0 |
| 一致性 | 十个坐席十个版本 | 第一通和第一万通同一套 |
| 衰减 | 会忘、会漏、状态有波动 | 不衰减 |
| 规则变了 | 全员重训,还得抽检 | 改一次,当天全员生效 |
| 人走了 | 知识跟着一起走 | 知识留在系统里 |
| 旺季扩容 | 招不到,也来不及培训 | 分钟级扩缩 |
这张表里最要命的是第二行和第六行:装第二份要从头再来一遍,人走了知识跟着走。两条加起来的意思是——培训投入永远无法沉淀。
而复制的边际成本接近零,意味着第一份知识挖得多深,后面每一份就有多深。
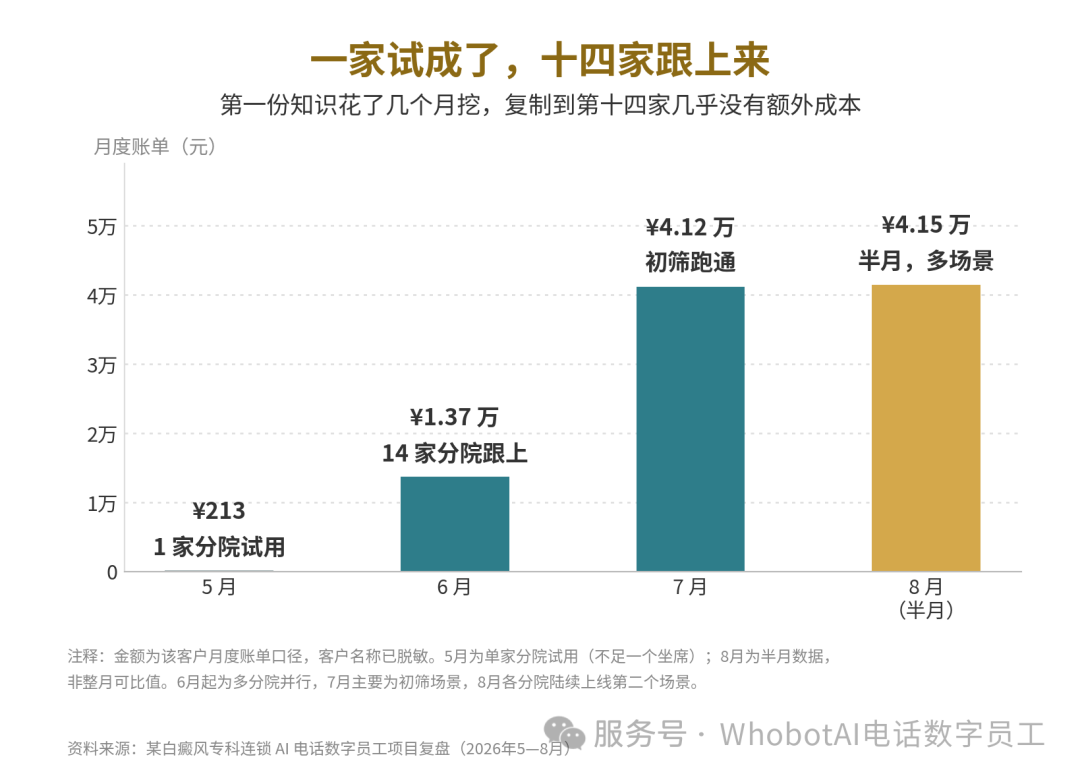
▲ 图4:五月一家分院试用,六月十四家一起跟上
这就是那条账单曲线的来历:五月一家分院试用 213 元,跑通之后六月十四家一起上 1.37 万,七月初筛稳定 4.12 万,八月上第二个场景,半个月 4.15 万。第一家花掉的是挖掘和校准的时间,后面十三家分到的是同一份成果。
这一节想说的
人学知识是「重装」,AI 学知识是「复制」。 在知识这一侧,比的从来不是聪明,是成本结构。
05判断这一侧,AI 进不来
但九成不是十成。剩下那一成,才是这件事真正的边界。
判断为什么不能被完整编码?三个原因:
- 它没有标准答案——同一个情形,两个高手会给出不同的处理,而且都对
- 它要担责——说错话的后果由人承担。这一点 AI 承担不了,也不该由它承担
- 它依赖场外信息——这个客户上周投诉过、这家分院刚被查过。这些不在任何系统里
而且判断那一侧还连着一层更麻烦的东西:隐性知识。
哪句话不能说、这个客户为什么必须先问那一句、上次那单是怎么黄的——这些按定义算知识(它们有答案),但它们不在任何文档里,只在人的脑子里。AI 自己猜不出来。
所以这类项目真正花时间的地方从来不是技术,是把这部分挖出来:
一对标真人录音
听这家公司做得最好的人自己是怎么说的,从真实表达里找边界。
二对标客户文档
把客户能说清的显性规则先固化下来。
三反复试听
把 AI 当成一个刚入职的新人带,逐句校准,站在对面的角度听哪里别扭。
四客户确认
拿不准的,回到最懂业务的人那里去问。
执行底线
不知道,就确认;不靠猜。
所以那一成不是残余,是壁垒。九成谁都能做,一成决定了谁能做成。
06怎么估自己岗位的那个比例
回到最开始的问题。要估一个岗位的可替代比例,别问「这个岗能不能被 AI 替代」——那个问题永远得不出答案。
换一个问法:这个岗位一天的时间,有多少花在有标准答案的事情上?
落到操作上,是两个问题:
一上手之前,要不要先学一套东西
规则、条款、产品、流程——需要学,说明这个岗位有一块可编码的知识底座。
二日常是不是同一套动作反复做
同一条链路、同一张表、同一个流程——是,说明那块底座每天都在被重复调用。
两个答案组合起来,就是四类岗位,可替代比例的高低也就出来了:
| 岗位特征 | 典型岗位 | 可替代比例 |
|---|---|---|
| 要先学 + 高重复 | 医疗初筛、保险回访 教培续费、招商初筛 | 最高 先动,而且最彻底 |
| 要先学 + 判断占比高 | 医生问诊、律师出方案 投顾配置 | 中等 AI 做助手,人做决定 |
| 不用学 + 高重复 | 转接、工单流转 状态查询 | 早就替完了 |
| 不用学 + 靠在场体力 | 搬运、清洁 门店接待 | 最低 AI 用不上 |
最后一步:
别在岗位层面纠结,把岗位拆成动作。 要懂但有标准答案的那些交出去,要懂且要拿主意的那些留给人。
07最后
回到那个公式。
存量人数和单人成本,是市场给你的,你只能选。
可替代比例不是——它写在岗位自己的结构里。
拆开看,九成是知识,一成是判断。
AI 拿走的是那九成。那一成,一直都在人手里。
上一篇《四十年的地理差价,吃到头了》中的成本阶梯口径:一线 2.59 / 省会 1.10 / 地级市 0.66 / 县域 0.60 元/分钟,人工为纯人力成本口径,不含线路费。
承德之后,再往哪搬